Meta entwickelt die App Forum mit KI-Agenten im Entwicklungsprozess
Metas neue App Forum vertieft Gespräche aus Facebook-Gruppen. Für die Entwicklung setzten die Ingenieure auf einen KI-Agenten, der fest im Entwicklungszyklus integriert war.
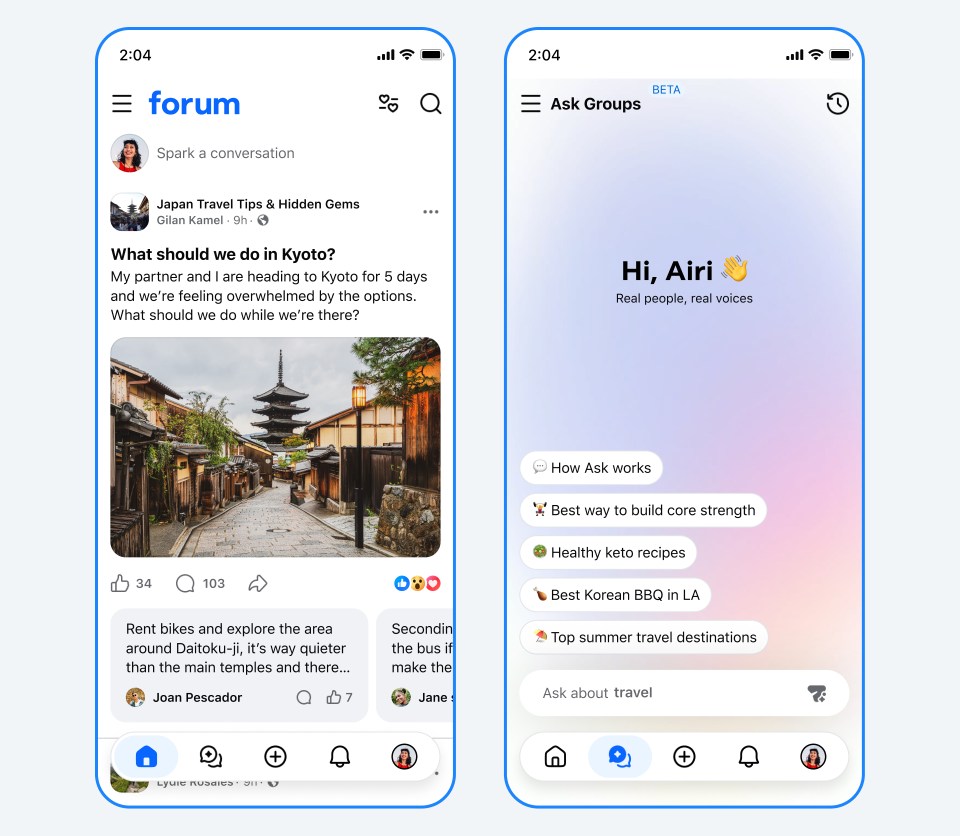
Forum ist eine eigenständige Groups-App, die ein kleines Team von Grund auf entwickelt hat. Sie war auch der Ort, an dem wir eine andere Arbeitsweise erprobt haben: ein KI-Agent als Teilnehmer im Engineering-Prozess, nicht als schnellere Art zu tippen.
Dieses Experiment brauchte eine Definition von Erfolg, und unsere war nicht die Menge an Code. Gemessen haben wir verifizierte, produktionsreife Ergebnisse, also Änderungen, die sich bauen lassen, Tests bestehen und eine Review überleben.
KI allein auf den Codierungsschritt zu richten, ändert wenig. Unsere Ergebnisse summierten sich, als wir den Ansatz auf die Schritte rund um die Implementierung ausdehnten: Planung, Erstellen, Testen und Verifizieren. Am deutlichsten zeigt sich der Wandel darin, wem jeder Schritt gehört.
Beim human-in-the-loop-Ansatz steuert der Ingenieur jeden Schritt, und die KI unterstützt ihn darin, indem sie eine Funktion autocompletes, einen Fix vorschlägt oder eine Frage beantwortet. Jede Iteration schreitet im Tempo der steuernden Person voran.
Beim human-on-the-loop-Ansatz führt der Agent die Iteration selbst aus, also planen, implementieren, bauen, testen, korrigieren und wiederholen, während der Ingenieur das Ziel setzt, den Ablauf beobachtet, eingreift, wenn er abweicht, und das Ergebnis freigibt. Die Aufgabe der Person verlagert sich vom Ausführen der Schritte auf das Verantworten des Ergebnisses und das Halten der Qualitätsmaßstäbe. Das ist das Ziel, auf das wir hinarbeiten, kein abgeschlossener Zustand: Manche Phasen laufen heute autonom, in anderen bleibt weiterhin ein Ingenieur in jeder Iteration.
Wenn der Ingenieur überwacht, hört die Arbeit auf, streng sequenziell zu sein. Zyklen, die früher nacheinander liefen, können sich überlappen, und die Zeit eines Ingenieurs fließt in Richtung und Urteilsvermögen statt in das reine Durchlaufen der Schleife. Das funktioniert jedoch nur, wenn man dem Ergebnis vertrauen kann. Ohne Verifizierung erzeugt KI-generierter Code ein bekanntes Problem: plausibel wirkende Ausgaben, bei denen niemand bestätigt hat, dass sie tatsächlich funktionieren, und die ein Ingenieur dann lesen, debuggen und oft verwerfen muss. Schwache Signale beseitigen die Einschränkung nicht; sie verlagern sie nur vom Schreiben von Code zum Review von Code, der fertig aussieht und es nicht ist.
Deshalb setzten wir die Messlatte bei der Verifizierung statt bei der Kompilierung. Kompilieren ist nicht die Ziellinie; eine Aufgabe gilt erst als abgeschlossen, wenn automatisierte Tests und visuelle Prüfungen bestanden wurden. Agents prüfen ihre eigene Arbeit, bevor ein Ingenieur sie sieht, was bedeutet, dass bei der Review ein kleineres Set aus Ergebnissen mit höherer Konfidenz ankommt statt eines Haufens von Ausgaben, den es zu sichten gilt. Weniger wird generiert und weniger wird verworfen. Jedes ausgelieferte Ergebnis trägt weiterhin die Freigabe eines Ingenieurs; unsere Mühe floss darauf, diese Freigabe schnell und gut belegt zu machen, mit Buildergebnissen, Testergebnissen und aufgezeichneten Verifizierungssitzungen, die der Änderung beiliegen.
Wenn der Ingenieur sich außerhalb jedes Zyklus befindet, muss die Schleife sicher eigenständig laufen. Vier Fähigkeiten machen das möglich:
Planung als technische Spezifikation: Agentic Execution erfordert extreme Präzision. Mehrdeutigkeiten, die ein Ingenieur durch Intuition auflösen würde, führen zum Scheitern des Agents. Wir investierten in konsequente Upstream-Zerlegung und maschinenlesbaren Kontext, was die Engineering-Schleife für Ingenieure und Agents gleichermaßen straffer machte.
Automatisierte Verifizierung innerhalb der Schleife ist der Kraftverstärker: Wir integrierten automatisierte Pass/Fail-Signale, etwa Build-Status, Unit-Tests und UI-Spec-Abgleich, direkt in die Agent-Schleife. Dies ermöglichte asynchrone Entwicklung, die reviewbereite Pull Requests mit vorausgefüllten Testplänen und aufgezeichneten Verifizierungssitzungen hervorbringt. Verifizierung ist der schwierige Teil, und wie viel wir sicher an die Schleife übergeben können, hängt davon ab, wie sehr wir den Prüfern vertrauen können.
Simuliertes Nutzertesting mit Agents: Wir setzten Navigations-Agents ein, die mit der Live-App genau so interagieren, wie es eine Person täte. Diese Agents führen Aktionen aus, lesen den Bildschirm und melden Regressionen. Navigations-Agents können dieselben Verifizierungspfade kontinuierlich durchlaufen.
Agentic Production Operations: Nach dem Launch unterstützen Agents die Automatisierung der Root-Cause-Analyse. Wenn jemand, der Forum nutzt, Feedback einreicht, nutzen die Agents dieses Feedback, um mögliche Regressionen zu untersuchen. Die Agents leiten die Analyse dann an Ingenieure weiter, die über das weitere Vorgehen entscheiden.
Dieses Ownership-Modell braucht eine Infrastruktur mit fünf zentralen Komponenten:
Die größten Gewinne kamen aus der Änderung unseres Codes und Toolings, nicht unserer Prompts.
Architektonische Lesbarkeit statt geerbter Komplexität: Wir bemühten uns, Forums Codebase so geradlinig wie möglich zu halten, und modularisierten gezielt zentrale Teile der Architektur, um von erprobter Infrastruktur zu profitieren und zugleich den Agents ein einfaches Plug-and-Play zu ermöglichen. Wo das nicht ohne Weiteres ging, bauten wir von Grund auf neu und tauschten Wiederverwendung gegen agentic Throughput, was sich in der Entwicklungsgeschwindigkeit auszahlte. Agents lernen Muster aus dem Code, den sie lesen. Behebt man ein schwaches Muster einmal, erbt jede künftige Agent-Sitzung die Verbesserung; lässt man es stehen, taucht derselbe Umweg in allem auf, was der Agent als Nächstes schreibt.
Agents Werkzeuge statt Beschreibungen geben: Unser häufigster Fehlermodus war, dass der Agent den Überblick verlor, wo es sich in der App befand, etwa indem es den Home-Feed bearbeitete, obwohl der Gruppen-Startbildschirm geändert werden sollte, oder indem es Bildschirmkoordinaten riet. Statt also dem Agenten die App zu beschreiben, gaben wir ihm Werkzeuge zum Nachprüfen: die Live-View-Hierarchie aus dem Simulator auslesen, die tatsächlich auf dem Bildschirm vorhandenen Elemente auflisten und den Pfad zu einer Ziel-View nachschlagen, alles, bevor es handelt. Fehlgeleitete Änderungen gingen deutlich zurück.
Denselben Ansatz wandten wir überall dort an, wo Agents unsere Systeme berührten: dem Agenten eine Möglichkeit geben, den Zustand direkt zu prüfen, statt einer Beschreibung zu vertrauen, von der aus es schlussfolgert.
Build-Level-Isolation für sicheres KI-Prototyping: Als Forum sich der Produktion näherte, wollten wir frühen Prototypen und agentengenerierten Experimenten Raum zum Ausprobieren geben, während die Produktions-App streng auf fertige, reviewte Arbeiten beschränkt blieb. Wir wollten eine stärkere Garantie als Feature-Gating allein, bei dem Prototyp-Code weiterhin im Production-Build existiert. Unsere Lösung war ein separater Build-Flavor, eine Sandbox-App, die exakt dieselbe Codebase, Frameworks und dasselbe Design-System wie die Produktion nutzt, aber Prototyp-Code über eine Plugin-Socket-Architektur vollständig aus dem Production-Build auskompiliert.
Dieses Muster erlaubte uns, schnelle KI-Iteration beizubehalten, obwohl wir inzwischen echte Nutzer der App zu schützen hatten.
Die Anpassung der Umgebung leistete mehr, als den Agenten beim Bauen schneller zu machen; sie machte den Agenten zum Tester. Wir richteten ihn nicht auf einen bestimmten Defekt. Stattdessen richteten wir wiederholbare Stresenszenarien ein, die echtes Nutzerverhalten nachahmen (aggressives Scrollen, zufälliges Durchstöbern von Gruppen, schnelle Navigation, wiederholtes Laden von Medien), und führten sie regelmäßig über Builds hinweg aus. Da diese Läufe konsistente Signale liefern, also Crashes, Speicherwachstum, Page Faults und UI-Regressionen, kann der Agent Anomalien triagieren, die auslösende Sequenz eingrenzen und anschließend der Ursache nachgehen.
Ein solcher Lauf förderte ein Speicherproblem zutage. Der Agent isolierte eine Reproduktion, schlug einen Fix vor und verifizierte ihn, alles während der Entwicklung, bevor die App Nutzer erreichte. Der Fix reduzierte das Speicherwachstum auf dem Gerät und die Page Faults über wiederholte Stresessitzungen hinweg erheblich.
Während die Ingenieure die architektonischen Entscheidungen trafen, waren Erkennung und Regressionsüberwachung automatisiert und wiederholbar; sobald eine Anomalie erkannt war, konnte der Agent reproduzieren, isolieren, einen Fix vorschlagen und mit demselben Harness verifizieren.
Den human-on-the-loop-Ansatz wandten wir an zwei Stellen an:
Beim Aufbau des Stacks: Agents kartierten die architektonischen Optionen und Kompromisse; die Ingenieure bewerteten und entschieden dann. Bewusst menschlich gehalten haben wir das Ziel: zu entscheiden, wie ein gutes Ergebnis aussieht, ist eine Produktentscheidung, die das System nicht für sich selbst definieren sollte.
Beim Betrieb des Stacks: Fragen, die früher den jeweils zuständigen Ingenieur erforderten, der den relevanten Codepfad kannte, gehen nun an einen Investigation-Agent, der die nötigen Informationen zusammenstellt und eine Ausarbeitung mit vorgeschlagenen Fixes postet. Nachdem wir eine Reihe echter Investigations manuell bewertet hatten, kamen wir zu einem Workflow, bei dem der Agent die mechanische Arbeit verdichtet und dem Ingenieur eine strukturierte Ausarbeitung liefert, der dann validiert, ob ein Befund ein echter Bug oder ein beabsichtigter Kompromiss ist.
Was die Qualität verbesserte, war kein besseres Prompting. Es war Kontext. Eine wiederkehrende Kategorie von Investigations lieferte schwache Ergebnisse, bis wir dem Agenten dieselben Verweise auf relevanten Code, Beispielabfragen und Design-Dokumente gaben, die wir jedem neuen Ingenieur am ersten Tag mitgeben würden. Die Qualität dieser Kategorie sprang deutlich nach oben. Der Unterschied zum menschlichen Onboarding ist, dass man einmal trainiert und jede künftige Sitzung darauf aufbaut.
Neben schnellerem Shipping lieferten wir auch sauberer. Kontinuierliche Verifizierung deckte systemische Probleme wie den oben genannten Speicherengpass bereits während der Entwicklung statt nach dem Launch auf. Die Ergebnisse zeigen sich im Leistungsprofil:
Die KI tat mehr, als Code zu generieren. Sie straffte unsere Qualitätsschleife und half einem kleinen Team, eine hochwertige App mit weniger laufendem Rework auszuliefern.
Wir danken Neeharika Sinha, Jane Kou, Gang Yang, Guohao Zhang, Zeya Zhang, Kinnary Jangla und Yonghui Lu für ihre wertvollen Beiträge.
Automatisch übersetzt. Das Original auf Englisch ist unten aufklappbar.
Original (Englisch) anzeigen
Forum is a standalone Groups app that a small team built from scratch. It’s also where we tested a different way of working: treating an AI agent as a participant in the engineering process rather than a faster way to type.
That experiment needed a definition of success, and ours wasn’t code volume. We measured verified, production-ready outcomes — changes that build, pass tests, and survive review.
Pointing AI at the coding step alone doesn’t change much. Our results compounded as we extended the approach to the stages around implementation — planning, building, testing, and verification. The clearest way to see the shift is in who owns each step.
With human-in-the-loop, the engineer drives every step and the AI assists inside it by autocompleting a function, suggesting a fix, or answering a question. Each iteration advances at the pace of the person driving it.
With human-on-the-loop, the agent runs the iteration itself — plan, implement, build, test, correct, repeat — while the engineer sets the goal, watches the run, steps in when it drifts, and approves the result. The person’s job moves from executing the steps to owning the outcome and holding the quality bar. This is the target we are driving toward, not a finished state: some stages run autonomously today, while others still keep an engineer in each iteration.
When the engineer supervises, work stops being strictly sequential. Cycles that used to run one at a time can overlap, and an engineer’s time goes to direction and judgment rather than to sitting through the loop. But that only holds if what comes back can be trusted. Without verification, AI-generated code creates a familiar problem — plausible output that no one has confirmed actually works, which an engineer then has to read, debug, and often discard. Weak signals don’t remove the constraint; they move it from writing code to reviewing code that looks finished and isn’t.
So we set the bar at verification rather than compilation. Compiling isn’t the finish line — a task is complete only once automated tests and visual checks have passed. Agents check their own work before an engineer sees it, which means what reaches review is a smaller set of higher-confidence results rather than a pile of output to sift through. Less gets generated, and less gets discarded. Every shipped outcome still carries an engineer’s sign-off; our effort went into making that sign-off fast and well-evidenced, with build results, test outcomes, and recorded verification sessions attached to the change.
With the engineer outside of every cycle, the loop has to run safely on its own. Four capabilities make that possible:
Planning as technical specification: Agentic execution requires extreme precision. Ambiguity that an engineer might resolve through intuition results in agent failure. We invested in rigorous upstream decomposition and machine-readable context, which tightened the engineering loop for engineers and agents alike.
Automated verification inside the loop is the force multiplier: We integrated automated pass/fail signals — build status, unit tests, and UI spec matching — directly into the agent loop. This enabled asynchronous development producing ready-to-review pull requests with pre-populated test plans and recorded verification sessions. Verification is the hard part to get right, and how much we can safely hand to the loop is gated by how much we can trust the verifiers.
Simulated user testing with agents: We deployed navigation agents that interact with the live app exactly like a person would. These agents perform actions, read the screen, and report regressions. Navigation agents are able to run the same verification paths continuously.
Agentic production operations: After launch, agents help automate root-cause analysis. When someone using Forum submits feedback, the agents use that feedback to investigate possible regressions. The agents then forward the analysis to engineers who decide the next course of action.
That ownership model needs machinery with five key components:
The biggest gains came from changing our code and tooling, not our prompts.
Architectural legibility over inherited complexity: We worked to keep Forum’s codebase as straightforward as possible and chose to modularize key pieces of the architecture in order to get the benefits of battle-tested infrastructure while also letting the agents plug and play easily. Where we couldn’t easily do so, we rebuilt from scratch, trading reuse for agentic throughput, and it proved rewarding in development speed. Agents learn patterns from the code they read. Fix a weak pattern once and every future agent session inherits the improvement; leave it and the same shortcut shows up in everything the agent writes next.
Give agents tools, not descriptions: Our main failure mode was the agent losing track of where it was in the app — editing the home feed when asked to change the group home screen, or guessing at screen coordinates. So instead of describing the app to the agent, we gave it tools to check: read the live view hierarchy from the simulator, list the elements actually on screen, and look up the path to a target view — all before it acts. Misdirected edits dropped sharply. We applied the same approach wherever agents touched our systems: give the agent a way to check state directly rather than a description to reason from.
Build-level isolation for safe AI prototyping: As Forum matured toward production, we wanted early-stage prototypes and agent-generated experiments to have room to run while keeping the production app strictly limited to finished, reviewed work. We wanted a stronger guarantee than feature gating alone, where prototype code still exists inside the production build. Our solution was a separate build flavor, a sandbox app that shares the exact same codebase, frameworks, and design system as production, but compiles prototype code out of the production build entirely via a plugin/socket architecture.
The pattern let us keep fast AI iteration after we had real people using the app to protect.
Adapting the environment did more than make the agent faster to build with — it made the agent a tester. We didn’t point it at one specific defect. Instead, we set up repeatable stress scenarios that mimic real user behavior (aggressive scrolling, random group browsing, rapid navigation, repeated media loading) and ran them routinely across builds. Because these runs produce consistent signals (crashes, memory growth, page faults, UI regressions), the agent can triage anomalies, narrow to the triggering sequence, and then investigate the root cause.
One such run surfaced a memory issue. The agent isolated a repro, proposed a fix, and verified it — all during development, before the app reached users. The fix materially reduced on-device memory growth and page faults across repeated stress sessions.
While engineers made the architectural decisions, the detection and regression monitoring were automated and repeatable; once an anomaly was detected, the agent could reproduce → isolate → propose a fix → verify with the same harness.
We applied the human-on-the-loop approach in two places:
Building the stack: Agents mapped the architectural options and trade-offs; engineers then evaluated and chose. What we deliberately kept human was the target — deciding what a good outcome looks like is a product judgment, not something the system should define for itself.
Operating the stack: Questions that used to require whichever engineer knew the relevant code path now go to an investigation agent that gathers what it needs and posts a write-up with suggested fixes. After hand-scoring a batch of real investigations we arrived at a workflow where the agent compresses the mechanical work and delivers a structured write-up to an engineer, who then validates whether a finding is a real bug or an intentional trade-off.
What improved quality wasn’t better prompting. It was context. One recurring category of investigation came back weak until we gave the agent the same pointers to the relevant code, example queries, and design docs that we’d give any new engineer on day one. The quality of that category jumped. The difference from human onboarding is that you train once, and every future session starts from it.
Beyond shipping faster, we shipped cleaner. Continuous verification surfaced systemic issues — like the memory bottleneck above — during development rather than after launch. The results show up in the performance profile:
The AI did more than generate code. It tightened our quality loop, helping a small team deliver a high-quality app with less ongoing rework.
We thank Neeharika Sinha, Jane Kou, Gang Yang, Guohao Zhang, Zeya Zhang, Kinnary Jangla, and Yonghui Lu for their valuable contributions.