AWS-Ansatz Trust in Depth soll Agenten mehr Autonomie bei Kontrolle ermöglichen
Der mehrschichtige Ansatz mit den Stufen Scope, Know, Bound, Observe und Prove lässt KI-Agenten selbstständig handeln, wenn ihre Aktionen überprüfbar sind. Menschliches Urteil bleibt den Entscheidungen vorbehalten, die es wirklich brauchen.
In jedem Gesprächauch mit Unternehmensführern höre ich dasselbe. Sie wollen, dass Agenten mehr übernehmen, aber sie vertrauen ihnen nicht, dies stets richtig zu tun.
Das ist verständlich. Dieselbe Kreativität und Autonomie, die Agenten nützlich macht, macht sie schwer einschätzbar. Gibt man einem Agenten eine Aufgabe, findet er seinen eigenen Weg, sie zu erledigen, und wählt dabei Werkzeuge und Schrittfolgen, die kein Entwickler vorgeschrieben hat. Führt man dieselbe Aufgabe zweimal aus, kann der Agent jedes Mal einen anderen Weg nehmen. Ein heute bestandener Test sagt wenig darüber aus, was der Agent morgen tut.
Die übliche Antwort ist ein Mensch in der Schleife, der jede Aktion des Agenten genehmigt. Das funktioniert in kleinem Maßstab, doch je mehr Arbeit Agenten übernehmen, stauen sich die menschlichen Freigaben und es entsteht eine Prüf-Erschöpfung. Menschen, die alles prüfen sollen, verpassen irgendwann das Wesentliche. Vorsicht wird zum Flaschenhals, und Agenten, die zu weit mehr fähig wären, bleiben untätig, statt die wertvolle Arbeit zu leisten, die größere Wirkung erzielen könnte.
Die Lösung besteht darin, den Agenten selbstständig handeln zu lassen, wenn seine Aktionen überprüfbar sind, und das menschliche Urteilsvermögen jenen Entscheidungen vorzubehalten, die es wirklich brauchen. Während Agenten Aufgaben mit höheren Risiken übernehmen, etwa finanzielle Transaktionen, wird eine falsche Aktion zunehmend folgenschwer. Unternehmen brauchen das Vertrauen, einem KI-Agenten wichtige Arbeit zu übergeben, in dem Wissen, dass er sich an den gesetzten Grenzen hält, selbst wenn niemand hinsieht. Dieses Vertrauen muss erst aufgebaut werden.
Inhaltsfilterung, Tests und Monitoring erfüllen jeweils einen wichtigen Zweck, doch keine dieser Fähigkeiten allein kann versprechen, dass sich ein Agent beim nächsten Lauf korrekt verhält. Vertrauen entsteht aus unabhängigen Schichten, die einander verstärken, dieselbe gestaffelte Disziplin, die die Branche seit zwei Jahrzehnten als Defense in Depth praktiziert, die nun einem neuen Zweck dient. Während Defense in Depth begrenzt, was schiefgehen kann, erweitert dieser Ansatz, was man sicher erlauben kann. AWS nennt es Trust in Depth.
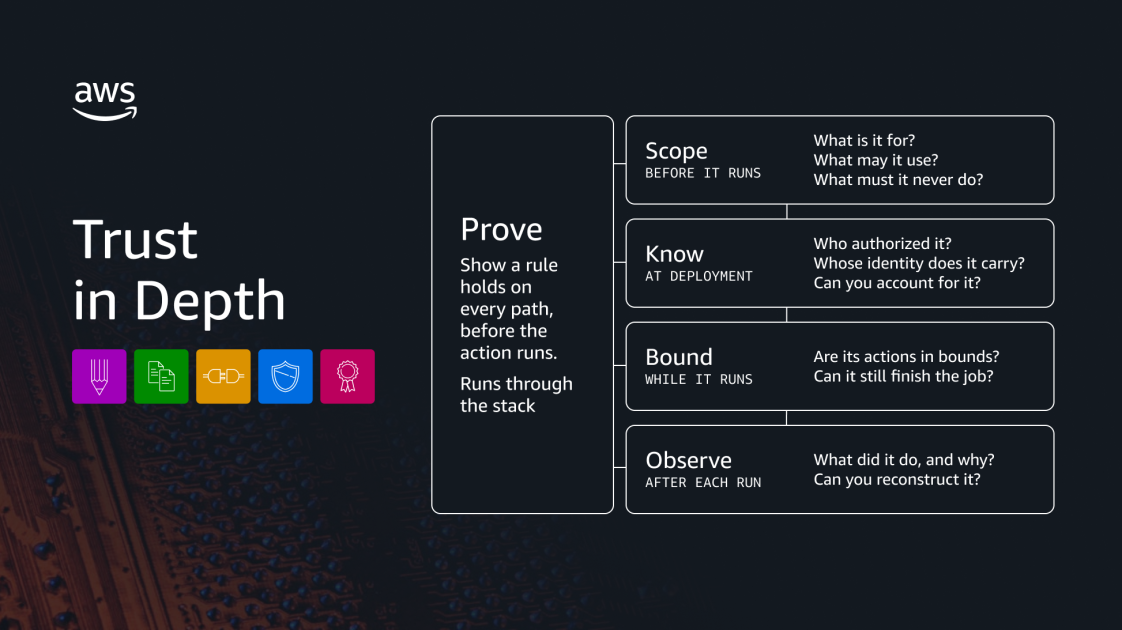
Vertrauen baut man auf, indem man eine Reihe von Fragen zu verschiedenen Zeitpunkten im Lebenszyklus des Agenten beantwortet:
Bei diesen Fragen lassen sich manche Anforderungen als präzise Regeln ausdrücken, während andere ein Urteilsvermögen erfordern. Ein Unternehmen könnte verlangen, dass nur ein Manager Zugriffe genehmigen darf, oder dass die Anmeldung eines Mitarbeiters blockiert sein muss, bevor dessen Postfach geteilt werden kann. Andere Erwartungen, wie etwa ein freundlicher Ton oder der angemessene Umgang mit einer heiklen Situation, hängen vom Kontext und vom menschlichen Urteil ab.
Bei präzise definierten Regeln zeigt das Testen, ob die Kontrollen in den erwarteten Fällen funktionieren, doch ein Agent beschreitet auch Wege, die man nicht vorhergesehen hat. Die Technologie, die weitergeht, ist automated reasoning, die mathematische Logik, die prüft, ob eine Regel in jedem möglichen Fall gilt. Sie kann belegen, dass eine Regel auf jedem Pfad gilt, der durch eine präzise Beschreibung des Systems und seiner Annahmen abgedeckt wird, oder den genauen Fall aufdecken, in dem sie versagt. Dieses Ergebnis ist ein Beweis, und er ist nur so gut wie die Regeln und Annahmen dahinter, weshalb die schwierigste Arbeit vor dem Lauf des Agenten ansteht.
AWS setzt automated reasoning seit mehr als einem Jahrzehnt produktiv ein, von Identity and Access Management (IAM) mit über 2,1 Milliarden Anfragen pro Sekunde bis hin zu kritischen Systemen wie dem AWS Nitro Hypervisor, Amazon S3 Block Public Access und dem VPC Reachability Analyzer. Jetzt bringen wir es zu Agenten. Wo sich die Regeln eines Agenten präzise formulieren lassen, kann automated reasoning sie prüfen.
Allerdings lässt sich nicht jede Regel präzise formulieren. „Nur ein Manager darf Zugriffe genehmigen“ lässt sich beweisen. „Halte einen freundlichen Ton“ lässt sich nicht beweisen. Wo ein Beweis nicht greift, begrenzt man den Zugriff und die Handlungen des Agenten, bewertet sein Verhalten und leitet echte Mehrdeutigkeiten an einen Menschen zur Beurteilung weiter. Mehr Autonomie gewährt man, wenn sich zeigt, dass die einschlägigen Regeln durchgesetzt werden, der Agent die Aufgabe zuverlässig erfüllt und Fehler erkannt und behandelt werden können.
Hier ist, was jede Trust-in-Depth-Schicht von Ihnen verlangt und wie AWS Ihnen hilft, sie zu beantworten.
Vertrauen beginnt, bevor ein Agent läuft, und genau hier sollte man den größten Aufwand investieren. Probleme, die hier erkannt werden, lassen sich kostengünstig beheben. Scoping bedeutet zu entscheiden, welche Arbeiten der Agent übernimmt, auf welche Werkzeuge, Daten und Dienste er zugreifen darf, welchen Regeln er folgen muss und welche Entscheidungen bei einem Menschen bleiben.
„Löse das Problem des Kunden“ sagt, was erreicht werden soll, nicht wie der Agent vorgehen darf. Der Agent braucht weiterhin Grenzen, was er sehen darf, was er tun darf und wann er anhalten und nachfragen muss. Gewährt ihm nur den Zugang, den seine Aufgabe erfordert, und nicht mehr. Achtet auf Fähigkeiten, die niemand absichtlich vergeben hat, die etwa mit einem Werkzeug oder einer Rolle mitgeliefert werden. Gewährt man eine Admin-Rolle für eine einzige Aufgabe, kann der Agent Berechtigungen über die gesamte Umgebung erben.
Scoping beginnt in der Build-Phase, bei der Definition des Agenten. Kiro, das agentic Coding-System, bringt Strenge und ausgereifte Ingenieurspraktiken in die Build-Phase von Agenten. Es wandert hochrangige Absichten in strukturierte, spezifikationsgetriebene Anforderungen um und nutzt automated reasoning, um Widersprüche, Mehrdeutigkeiten und Lücken aufzudecken, bevor Code geschrieben wird.
Kiro leitet außerdem property-basierte Tests ab, die die Implementierung über ein breites Spektrum an Eingaben gegen diese Anforderungen prüfen und so schwer erkennbare Fehler finden. Strands stellt ein Open-Source-Werkzeugset bereit, um Modell, Anweisungen und Werkzeuge eines Agenten zu definieren, sowie eine verwaltete Laufzeitumgebung für den Betrieb. Welches Framework man auch wählt, die Verantwortung, die Aufgabe des Agenten und seine Grenzen zu definieren, bleibt dieselbe.
Der nächste Schritt besteht darin, diese Grenzen in Regeln zu überführen, an die man den Agenten binden kann. Amazon Bedrock AgentCore bietet Governance-Kontrollen, um Agenten sicher zu skalieren und ihr Handeln zu regeln. Mit Policies in Bedrock AgentCore beschreibt man in einfacher Sprache, auf welche Werkzeuge, APIs und Daten der Agent zugreifen darf, und automated reasoning prüft die Policy auf Lücken, etwa eine Regel, die zu viel Zugriff gewährt, sowie auf Widersprüche, die eine Regel unerfüllbar machen, bevor sie in Kraft tritt.
Das Scoping des Agenten ist der schwierige Teil, denn die Überführung menschlicher Absichten in eine dauerhafte, durchsetzbare Policy erfordert Präzision und Vollständigkeit. Doch es ist auch der Teil, der sich am meisten auszahlt. Alles baut darauf auf, was man hier festlegt, und je präziser die Policy, desto mehr kann der Agent sicher selbstständig tun.
Man kann nicht regeln, was man nicht sehen kann. Teams erstellen Agenten schneller, als jemand sie verfolgen kann, und ein Agent, von dem niemand weiß, ist ein Agent, den niemand kontrolliert. Jeder Agent braucht eine eigene Identität, die bei jeder Aktion überprüft wird. Keine Aktion sollte ohne Zuordnung bleiben. Wenn etwas schiefgeht, lässt sich feststellen, welcher Agent was getan hat und wer es genehmigt hat.
AWS Agent Registry bietet einen verwalteten, genehmigten Katalog der Agenten, Model Context Protocol (MCP) Server, Werkzeuge und Fähigkeiten im gesamten Unternehmen. Administratoren nutzen Genehmigungs-Workflows, um zu steuern, was auffindbar wird, und zu entfernen, was den Anforderungen an Sicherheit, Compliance und Qualität nicht mehr genügt. Sowohl Menschen als auch Agenten können finden und wiederverwenden, was bereits existiert, statt es neu aufzubauen. Ein Katalog zeigt aber nur, was existiert. Sobald die Agenten bekannt sind, stellt AgentCore jedem Agenten eine eigene Identität aus und prüft sie bei jeder Anfrage, sodass jede Aktion auf einen bestimmten Agenten unter einer bekannten Berechtigung zurückzuführen ist. So weiß man, welcher Agent in Ihrem Namen handelt.
Grenzen zu setzen ist wichtig, denn ein Agent kann zehn Schritte ausführen, die man genehmigt hat, und dennoch ein Ergebnis erreichen, das niemand beabsichtigt hat. Er kann sensible Daten offenlegen, vom Thema abweichen oder zulässige Aktionen so kombinieren, dass Ihre Policies sie verbieten. Grenzen können in beide Richtungen versagen.
Zu weitläufig, und der Agent kann tun, was er nicht sollte. Zu eng, und er kann seine Aufgabe gar nicht erfüllen. Lässt man den Agenten also wählen, wie er seine Aufgabe verfolgt, sollte man sich niemals darauf verlassen, dass er seine eigenen Grenzen durchsetzt.
Diese Grenzen definieren die Handlungsspielräume des Agenten und gehören in die Umgebung um den Agenten herum, deterministisch durchgesetzt und über die gesamte Abfolge der Aktionen bewertet, nicht Schritt für Schritt.
Hier greift die Policy, die Sie im Scoping definiert haben. Policy in AgentCore setzt sie bei jedem Werkzeugaufruf durch, der über das AgentCore Gateway läuft, einen sicheren Einstiegspunkt für Agenten, Werkzeuge und Modelle. Da die Durchsetzung außerhalb des Denkens des Agenten sitzt, bleiben dieselben Prüfungen wirksam, selbst wenn der Agent fehlerhaft ist, manipuliert wurde oder einem Prompt Injection-Angriff ausgesetzt ist: Er kann eine Kontrolle nicht abschalten, die er nicht selbst ausführt.
Auch die Berechtigung muss nicht starr bleiben. Da sich das Risiko einer Aufgabe im Verlauf ändert, werten temporal policies ab, was in einer Sitzung bereits geschehen ist, und passen die Berechtigungen an, während die Arbeit fortschreitet. Amazon Bedrock Guardrails regelt, was der Agent sagt und was ihm mitgeteilt wird.
Er filtert schädliche oder themenfremde Inhalte heraus und schwärzt sensible Daten. Automated Reasoning checks gehen weiter und beweisen, dass eine Antwort mit der von Ihnen festgelegten Policy übereinstimmt, nicht mit der Interpretation des Modells davon.
Grenzen bestimmen auch, worauf ein Agent überhaupt zugreifen kann: welche Dateien er berühren darf, welche Dienste er aufrufen darf und welche Zugangsdaten er verwenden darf. Strands Box, eine Open-Source-Sandbox, setzt diese Grenzen von außen durch, unabhängig von den Anweisungen des Agents, sodass der Agent mit echten Tools und Daten arbeiten kann, aber nur das erreicht, was Sie erlauben. Dieselben Grenzen gelten vom ersten lokalen Entwicklersitzung bis in die Produktion, sodass ein Agent in der Produktion nichts tun kann, was er in der Entwicklung nicht konnte.
Auch wenn Scoping, Identität und Grenzen vorhanden sind, kann ein Agent in Millisekunden antworten, ohne Fehler und mit allen Dashboards im grünen Bereich, und trotzdem das Falsche tun. Er hat möglicherweise die falschen Informationen abgerufen, das falsche Tool gewählt oder einen Pfad eingeschlagen, den niemand erwartet hat. Ein gesundes System ist nicht dasselbe wie eine erfolgreiche Aufgabe.
Um den Unterschied zu erkennen, muss man rekonstruieren, was der Agent tatsächlich getan hat: den Kontext, den er erhalten hat, die Tools, die er aufgerufen hat, die angewandten Richtlinienentscheidungen und das Ergebnis. Tests vor der Bereitstellung bleiben unverzichtbar. Die Produktion liefert zusätzlich Belege über das Verhalten unter realen Bedingungen und gibt Betreibern, was sie benötigen, um Vorfälle zu untersuchen, einzugreifen und zu verbessern.
Amazon CloudWatch Omni wurde für kontinuierliche Beobachtung entwickelt. Es erfasst jede Spur und stellt jeden Schritt, den ein Agent unternommen hat, von Modellaufrufen bis zu Tool-Aufrufen, auf einer Zeitleiste dar, die ein Team untersuchen kann. Die integrierten Evaluatoren bewerten die Antworten des Agents hinsichtlich Qualitäten, die das übliche Monitoring verpasst, wie Korrektheit, Treue zum Kontext und ob der Agent das richtige Tool gewählt hat. Und die Spuren, in denen ein Agent falsch lag, werden zu dem Datensatz, gegen den man die Korrektur testet, sodass der Betrieb eines Agents und seine Verbesserung auf dieselben Belege zurückgreifen.
Ein Manager bittet einen Helpdesk-Agenten, Sam abzumelden, einen Account Manager, der das Unternehmen verlässt. Der Agent muss Sams Zugriff entfernen, sein Postfach an seinen Nachfolger übertragen und die Lizenz freigeben, die das Unternehmen nicht mehr benötigt. Sams E-Mails enthalten jedoch möglicherweise auch Belege für einen Kundenstreit. Die falsche Reihenfolge könnte dazu führen, dass Sam nach seinem Ausscheiden noch Zugriff hat oder dass diese Belege gefährdet werden. Sicherheit, Messaging, Recht und Finanzen haben jeweils Anforderungen, die der Agent einhalten muss, obwohl niemand den gesamten Workflow skriptiert hat.
Zwei Regeln bestimmen die Reihenfolge. Sams Anmeldung muss blockiert werden, bevor sein Postfach konvertiert und mit seinem Nachfolger geteilt werden kann. Bevor seine E-Mail-Lizenz geändert wird, muss der Agent nach einer rechtlichen Sperrprüfung suchen, einer Anforderung, Unterlagen für einen Streitfall aufzubewahren, und bestätigen, dass die Änderung diese Unterlagen geschützt bleibt.
Scope. Bevor der Agent ausgeführt wird, schreibt das Team diese Regeln als Richtlinien in AgentCore. Jede Richtlinie verlangt, dass der vorangegangene Schritt für Sams Konto bereits erfolgreich abgeschlossen wurde, bevor der nächste Schritt ausgeführt werden kann. Der Agent erhält genau sechs Tools: Anmeldung blockieren, rechtliche Sperren prüfen, eine Sperre verhängen, ein Postfach konvertieren, dem Nachfolger Zugriff gewähren und eine Lizenz ändern. Es erhält kein Tool zum Löschen des Kontos, weil das geteilte Postfach das Konto benötigt.
Know. Der Agent führt seine eigene Identität mit sich, sodass jede Änderung an Sams Konto auf ihn zurückverfolgt werden kann.
Bound. Der Agent versucht, Sams Postfach in ein geteiltes Postfach für Priya, die Nachfolgerin, zu konvertieren. Die Richtlinie in AgentCore, durchgesetzt am AgentCore Gateway, blockiert den Aufruf: Sam kann sich noch immer anmelden, und die Konvertierung des Postfachs würde sein Passwort nicht ändern, sodass seine alten Zugangsdaten es weiterhin öffnen könnten.
Der Agent blockiert Sams Anmeldung, konvertiert dann das Postfach und gewährt Priya Zugriff. Als nächstes wendet er sich der eigentlichen Anfrage des Managers zu, der Freigabe der Lizenz, aber das Gateway blockiert auch das, weil niemand Rechts Sperrliste geprüft hat. Der Agent prüft und stellt fest, dass die Rechtsabteilung verlangt, Sams E-Mails für einen Kundenstreit aufzubewahren.
Er verhängt die Sperre, bestätigt, dass sie wirksam ist, und ändert dann Sams Lizenz auf eine, die diesen Schutz unterstützt. Das Unternehmen kann die umfassendere Lizenz zurückholen und die Belege bleiben erhalten.
Observe. Jeder Schritt wird aufgezeichnet: was der Agent zu tun versuchte, was die Regeln entschieden, die Sperre und das Ergebnis.
Der Agent hat die Aufgabe abgeschlossen, ohne dass eine Person jeden Schritt genehmigen musste. Seine Berechtigungen begrenzten, was er ändern konnte, seine Identität machte diese Änderungen nachvollziehbar, und Richtlinien hinderten ihn daran zu handeln, bevor die erforderlichen Sicherheitsvorkehrungen getroffen waren. Die aufgezeichneten Schritte ermöglichten es dem Team zu überprüfen, dass Sams Zugriff blockiert war, seine Nachfolgerin das Postfach nutzen konnte und die erforderlichen Belege geschützt blieben.
AWS bringt diese Schichten zusammen, damit Sie einen Agenten auf seine Aufgabe beschränken können, wissen, welche Agenten für Sie handeln, begrenzen, was sie tun und sagen, sehen, was sie getan haben, und sich im Laufe der Zeit verbessern können, und beweisen können, dass Ihre Regeln gelten, wo immer sie sich präzise formulieren lassen. Keine einzelne Schicht verdient dieses Vertrauen allein. Zusammen sind sie Trust in Depth, und sie machen aus einem fähigen Agenten einen Agenten, dem man zutrauen kann, wichtige Arbeit zu erledigen.
Sie ziehen die Linien: was ein Agent eigenständig tun darf, was die Genehmigung einer Person erfordert und wann er anhalten muss. Das befreit Ihre Mitarbeiter für das, was nur Menschen können: schwierige Abwägungen treffen, Grauzonen klären und die Entscheidungen verantworten, die Sie bewusst in menschlicher Hand behalten möchten. Während sich Belege dafür häufen, dass ein Agent innerhalb dieser Linien bleibt, können Sie seine Verantwortlichkeiten erweitern oder einschränken.
Bei AWS sind wir überzeugt, dass jede Organisation, die Agenten auf beliebigen Plattformen einsetzt, diese vier Fragen mit Belegen beantworten können sollte, und mit Beweisen, wo immer sie anwendbar sind. Das ist der Maßstab, den AWS für unsere Kunden setzt, und derjenige, zu dem wir die Branche einladen, sich zu verpflichten. Defense in Depth machte es sicher, Systeme mit der Welt zu verbinden. Trust in Depth macht es sicher, Agenten darin autonom handeln zu lassen.
Beginnen Sie mit einem Agenten, einem Workflow und einer Grenze, die Sie beweisen können. Erweitern Sie dann, während das Vertrauen wächst.
Um mit durchsetzbaren Regeln zu beginnen, erkunden Sie Policy in Amazon Bedrock AgentCore und Automated Reasoning checks in Amazon Bedrock Guardrails.
Shawn ist Vice President of AI Services bei Amazon Web Services (AWS), wo er die Automated Reasoning Group leitet. Die Kernmission des Teams ist die Förderung der Sicherheit von KI-Agenten. Shawn treibt Wissenschafts- und Produktteams an, neurosymbolische KI, die große Sprachmodelle mit formaler Verifikation kombiniert, in Entwicklerwerkzeuge zu bringen, damit jeder Entwickler vertrauenswürdige KI-Agenten erstellen kann, deren zentrale Verhaltensweisen mathematisch bewiesen sind. Über fast 30 Jahre hat Shawn Sicherheits-, Daten- und Produktorganisationen bei AWS, Microsoft und Splunk geleitet. Er begann seine Karriere als Offizier der U.S. Army in der 25th Infantry Division.
Automatisch übersetzt. Das Original auf Englisch ist unten aufklappbar.
Original (Englisch) anzeigen
In every conversation I have with enterprise leaders, they say the same thing. They want agents to do more, but they don’t trust them to do it right all the time.
That’s fair. The same creativity and autonomy that makes agents useful makes them hard to trust. Give an agent a task and it finds its own path to finish it, picking tools and sequencing steps no developer scripted. Run the same task twice and it might take a different route each time. A test that passes today tells you little about what the agent does tomorrow.
The usual answer is a person in the loop, approving everything the agent does. That works at small scale, but as agents take on more work, human approvals pile up and review fatigue sets in. People asked to check everything stop catching the things that matter. Caution becomes a bottleneck, and agents capable of far more sit idle on the valuable work that could be making more of an impact.
The fix is to let the agent act on its own when its actions can be verified, and reserve human judgment for the decisions that need it. As agents take on higher stakes work, like financial transactions, a wrong action becomes increasingly harmful. Organizations need the confidence to hand an AI agent important work, knowing it will stay within the limits set, even when no one is watching. That confidence must be built.
Content filtering, testing, and monitoring each serve an important purpose, but none of these capabilities alone can promise an agent will behave correctly the next time it runs. Trust comes from independent layers that reinforce one another, the same layered discipline the industry has practiced for two decades as Defense in Depth, turned to a new purpose. Where Defense in Depth limits what can go wrong, this expands what you can safely allow. AWS calls it Trust in Depth.
You build trust by answering a set of questions at different moments in the agent’s lifecycle:
Across these questions, some requirements can be expressed as precise rules, while others call for judgment. A company might require that only a manager can approve access, or that an employee’s sign-in must be blocked before their mailbox can be shared. Other expectations, such as keeping a friendly tone or handling a sensitive situation appropriately, depend on context and human judgment.
For precisely defined rules, testing shows whether the controls work in the cases you anticipate, but an agent takes paths you didn’t. The technology that goes further is automated reasoning, the mathematical logic that checks whether a rule holds in every possible case. It can establish that a rule holds on every path covered by a precise description of the system and its assumptions, or uncover the exact case where it fails. That result is a proof, and it is only as good as the rules and assumptions behind it, which is why the hardest work comes before the agent runs.
AWS has run automated reasoning in production for more than a decade, from Identity and Access Management (IAM) at more than 2.1 billion requests per second to critical systems like the AWS Nitro Hypervisor, Amazon S3 Block Public Access, and VPC Reachability Analyzer. Now we are bringing it to agents. Wherever an agent’s rules can be stated precisely, automated reasoning can check them.
However, not every rule can be stated precisely. “Only a manager can approve access” can be proven. “Keep a friendly tone” cannot. Where proof does not apply, limit the agent’s access and actions, evaluate its behavior, and send genuine ambiguity to a person to apply judgment. Grant more autonomy as you establish that the relevant rules are enforced, the agent performs reliably on the task, and failures can be detected and handled.
Here is what each Trust in Depth layer asks of you, and how AWS helps you answer it.
Trust begins before an agent runs, and this is where to invest the most effort. Problems caught here are cheap to fix. Scoping means deciding what work the agent owns, which tools, data, and services it may reach, the rules it must follow, and which decisions stay with a person.
“Resolve the customer’s issue” says what to achieve, not how the agent may act to achieve it. The agent still needs limits on what it may see, what it may do, and when it must stop and ask. Give it only the access its job requires, and no more. Watch for capabilities no one granted on purpose, the ones bundled with a tool or a role. Grant an admin role for one task, and the agent can inherit permissions across your whole environment.
Scoping starts at the build stage, with how you define the agent. Kiro, the agentic coding system, brings rigor and mature engineering practices to the build stage of agents. It turns high-level intent into structured, spec-driven requirements and uses automated reasoning to surface contradictions, ambiguities, and gaps before any code is written. Kiro also derives property-based tests that check the implementation against those requirements across a wide range of inputs, catching bugs that are hard to detect. Strands provides an open-source tool kit for defining an agent’s model, instructions, and tools, and a managed runtime for operating it. Whatever framework you choose, the responsibility to define the agent’s job and its boundaries is the same.
The next step is turning those boundaries into rules you can hold the agent to. Amazon Bedrock AgentCore provides governance controls to scale agents safely and governs what the agent does. Using Policies in Bedrock AgentCore, you describe in plain language which tools, APIs, and data the agent may reach, and automated reasoning checks the policy for gaps, like catching a rule that grants too much access, and checks for contradictions that make a rule unable to ever be satisfied, before it takes effect.
Scoping your agent is the hard part, because turning human intent into durable, enforceable policy requires precision and completeness. However, it is also the part that pays off most. Everything that builds on what you set here, and the more precise the policy, the more your agent can safely do on its own.
You can’t govern what you can’t see. Teams are creating agents faster than anyone can track them, and an agent no one knows about is an agent no one controls. Every agent needs its own identity, checked every time it acts. No action should be orphaned. When something goes wrong, you can tell which agent did what, and who authorized it.
AWS Agent Registry provides a managed, approved catalog of the agents, Model Context Protocol (MCP) servers, tools, and skills across your organization. Administrators use approval workflows to gate what becomes discoverable and remove what no longer meets the bar for security, compliance, and quality. Both people and agents can find and reuse what already exists instead of rebuilding it. But a catalog only tells you what exists. Once the agents are known, AgentCore issues each agent its own identity and checks it on every request, so every action traces back to a specific agent operating under a known authority. That is how you know every agent acting on your behalf.
Setting boundaries matters because an agent can take 10 steps you approved and still reach an outcome no one intended. It can expose sensitive data, drift off topic, or combine permitted actions in ways your policies forbid. Limits can fail in both directions. Too loose, and the agent can do what it shouldn’t. Too tight, and it can’t do its job at all. So let the agent choose how to pursue its task but never rely on it to enforce its own limits. Those limits define the agent’s boundaries and belong in the environment around the agent, enforced deterministically and evaluated across the full sequence of actions, not one step at a time.
This is where the policy you defined in Scope takes effect. Policy in AgentCore enforces it on every tool call routed through AgentCore Gateway, a secure entry point for agents, tools, and models. Because enforcement sits outside the agent’s reasoning, the same checks can hold even when the agent is buggy, manipulated, or hit with a prompt injection: it cannot turn off a control it does not run.
Authority does not have to stay fixed either. Because a task’s risk changes as it proceeds, temporal policies weigh what has already happened in a session and adjust permissions as the work continues. Amazon Bedrock Guardrails governs what the agent says and is told.
It filters harmful or off-topic content and redacts sensitive data. Automated Reasoning checks go further, proving a response is consistent with the policy you set, not the model’s interpretation of it.
Boundaries also govern what an agent can reach in the first place: which files it can touch, which services it can call, and which credentials it can use. Strands Box, an open-source sandbox, enforces those boundaries from outside the agent’s instructions, so the agent can work with real tools and data but reach only what you allow. The same boundaries hold from a developer’s first local session through to production, so an agent can’t do in production what it couldn’t in development.
Even with scoping, identity, and boundaries in place, an agent can respond in milliseconds, with no errors and every dashboard green, and still do the wrong thing. It may have retrieved the wrong information, chosen the wrong tool, or followed a path no one expected. A healthy system is not the same as a successful task. To tell the difference, you must reconstruct what the agent actually did: the context it received, the tools it called, the policy decisions applied, and the result. Testing before deployment remains essential. Production adds evidence about behavior under real conditions and gives operators what they need to investigate, intervene, and improve.
Amazon CloudWatch Omni is built for continual observation. It captures every trace and lays out each step an agent took, from model calls to tool invocations, on a timeline a team can investigate. Its built-in evaluators score agent responses for qualities standard monitoring misses, such as correctness, faithfulness, and whether the agent chose the right tool. And the traces where an agent went wrong become the dataset you test the fix against, so operating an agent and improving it draw on the same evidence.
A manager asks a help desk agent to offboard Sam, an account manager who is leaving the company. The agent needs to remove Sam’s access, transfer his mailbox to his successor, and free up the license the company no longer needs. But Sam’s emails may also contain evidence needed for a client dispute. The wrong sequence could leave Sam with access after he leaves or put that evidence at risk. Security, messaging, legal, and finance each have requirements the agent must follow, even though no one has scripted the full workflow.
Two rules govern the sequence. Sam’s sign-in must be blocked before his mailbox can be converted and shared with his successor. Before changing his email license, the agent must check for a legal hold, a requirement to preserve records for a dispute, and confirm the change keeps those records protected.
Scope. Before the agent runs, the team writes these rules as policies in AgentCore. Each policy requires that the prerequisite step already succeeded for Sam’s account before the next step can run. The agent gets exactly six tools: block sign-in, check for legal holds, place a hold, convert a mailbox, give the successor access, and change a license. It gets no tool to delete the account, because the shared mailbox needs the account to survive.
Know. The agent carries its own identity, so every change to Sam’s account traces back to it.
Bound. The agent tries to convert Sam’s mailbox to a shared one for Priya, the successor. Policy in AgentCore, enforced at the AgentCore Gateway, blocks the call: Sam can still sign in, and converting the mailbox wouldn’t change his password, so his old credentials would still open it.
The agent blocks Sam’s sign-in, then converts the mailbox and gives Priya access. Next it moves to the manager’s actual request, freeing up the license, but the gateway blocks that too, because no one has checked Legal’s hold list. The agent checks and finds that Legal requires Sam’s emails to be preserved for a client dispute.
It places the hold, confirms it is in effect, then changes Sam’s license to one that supports that protection. The company can reclaim the broader license while keeping the evidence intact.
Observe. Every step is recorded: what the agent tried to do, what the rules decided, the hold, and the outcome.
The agent completed the task without a person approving every step. Its permissions limited what it could change, its identity made those changes traceable, and policies stopped it from acting before the required safeguards were in place. The recorded steps let the team verify that Sam’s access was blocked, his successor could use the mailbox, and the required evidence remained protected.
AWS brings these layers together so you can scope an agent to its job, know which agents are acting for you, bound what they do and say, see what they did and improve over time, and prove your rules hold wherever they can be stated precisely. No one layer earns that trust on its own. Together, they are Trust in Depth, and they are what turns a capable agent into an agent that can be trusted to do important work.
You draw the lines: what an agent may do on its own, what needs a person’s approval, and when it must stop. That frees your people for what only people can do: weigh the hard calls, resolve the gray areas, and own the decisions you choose to keep in human hands. As evidence builds that an agent stays inside those lines, you can widen its responsibilities or narrow them.
At AWS, we believe every organization deploying agents, on any platform, should be able to answer these four questions with evidence, and with proof wherever it applies. That is the bar AWS is building for our customers, and the one we invite the industry to hold itself to. Defense in Depth made it safe to connect systems to the world. Trust in Depth makes it safe to let agents act autonomously within it.
Start with one agent, one workflow, and one boundary you can prove. Then expand as the trust is earned.
To begin implementing enforceable rules, explore Policy in Amazon Bedrock AgentCore and Automated Reasoning checks in Amazon Bedrock Guardrails.
Shawn is Vice President of AI Services at Amazon Web Services (AWS), where he leads the Automated Reasoning Group. The team’s core mission is advancing AI agent safety. Shawn drives science and product teams to bring neurosymbolic AI, which combines large language models with formal verification, into developer tooling so every builder can create trustworthy AI agents whose key behaviors are mathematically proved. Over nearly 30 years, Shawn has led security, data, and product organizations at AWS, Microsoft, and Splunk. He began his career as a U.S. Army officer in the 25th Infantry Division.