Google und Meta veröffentlichen TorchTPU für natives PyTorch auf TPUs
Auf der PyTorch Conference North America 2026 haben Google und Meta TorchTPU als Open-Source-Backend für TPUs freigegeben. Meta will damit größere LLM-Workloads auf TPUs verlagern, während AWS zeitgleich TorchNeuron für Trainium herausbrachte.
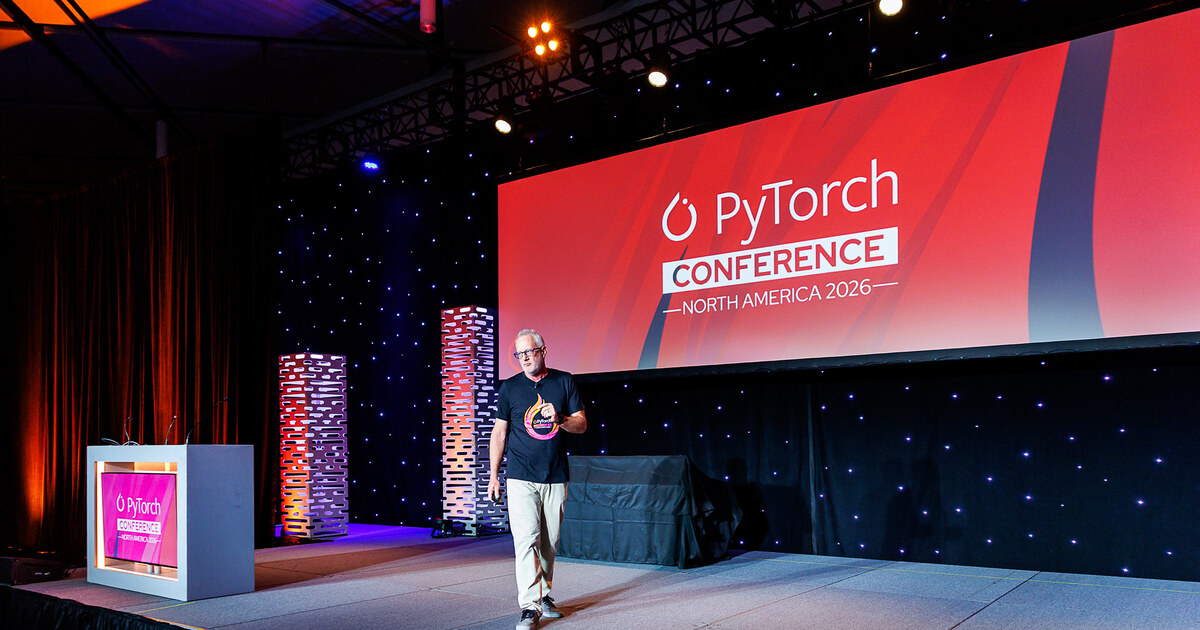
TorchTPU ersetzt PyTorch/XLA, eine Lazy-Tensor-Brücke aus dem Jahr 2020, die laut der Ankündigung "aufdringliche Modifikationen am Quellcode erforderlich machte". Das neue Backend soll die Portierung eines Modells so einfach machen wie die Änderung von model.to("cuda") zu model.to("tpu"). "Mit TorchTPU werden TPUs neben GPUs und CPUs zu einer nativen Option für PyTorch", schrieb Google Cloud in seiner Ankündigung, die von Bill Jia, VP of Engineering für Core ML/AI, mitverfasst wurde.
Jia präsentierte die Keynote "Workload Fungibility in the Agentic Era: Bringing Native PyTorch to Cloud TPUs" zusammen mit Zhou, nachdem zwei Vorträge die Nachfrage eingeordnet hatten. Mark Collier, Geschäftsführer der PyTorch Foundation, sagte, dass Inferenz das Training als größte Datacenter-Workload überholt habe und eine "unglaubliche Gier nach Tokens" entstanden sei. Collier beschrieb das Ziel der Community als Open-Source-Software für Modelle, die "auf jedem Chip in jeder Cloud laufen und sich mit jedem Agenten verbinden". Die Keynote-Folien der Foundation zeigten, wie schnell sich dieser Markt bewegt: DeepSeeks Flash-Modell wurde innerhalb von 37 Tagen 60 Prozent günstiger, und Kimi K3 lief innerhalb von 33 Tagen auf derselben Hardware 68 Prozent schneller.
Mazin Gilbert, Geschäftsführer der Agentic AI Foundation, sagte, der Token-Verbrauch von Agenten habe den menschlichen Verbrauch am 6. Februar 2026 übertroffen. Er ist seitdem um das 14-Fache gewachsen, gegenüber dem 2,8-Fachen bei Menschen. "Das ist im Grunde ein Hockey-Stick, der explodiert", sagte Gilbert. Anwender sollten vor der Wiederverwendung dieser Zahlen den Geltungsbereich prüfen, da die öffentlichen Daten von einer einzigen Plattform stammen, OpenRouter.
Da TorchTPU in den Low-Level-Dispatcher von PyTorch eingreift, so die Referenten, funktionierten Hugging-Face-Modelle ohne weitere Anpassungen damit. Die Inferenz-Engines vLLM und SGLang laufen nativ, und TorchTitan unterstützt dense Modelle, Mixture-of-Experts-Modelle und Diffusionsmodelle für das Training im großen Maßstab. Ray und llm-d skalieren TPU-Workloads über mehrere Hosts auf Kubernetes. Vier Repositories wurden als Open Source veröffentlicht: TorchTPU, vLLM-TorchTPU, SGLang-TorchTPU und TorchTitan.
Jia zeigte eine nahezu lineare Skalierung über 8.000 TPU-Chips hinaus, wobei der Durchsatz pro Chip mit wachsendem Cluster ungefähr konstant blieb. Zu den veröffentlichten Ergebnissen von Google gehört ein Qwen3 235B Mixture-of-Experts-Lauf auf 8.192 TPU v7x Chips mit einer Model-FLOPs-Auslastung von 28 Prozent. In der Ankündigung wird offen eingeräumt, dass die Ein-Zeilen-Änderung nur ein Ausgangspunkt ist:
Mit dieser simplen Änderung lässt sich keine Spitzenleistung der TPU erreichen, da die Shapes, das Sharding und die Operationen eines Modells auf eine GPU-Architektur ausgerichtet sein können; das Modell sollte jedoch ohne weitere Anpassungen laufen.
Antwortet Google auf diese Optimierungslücke mit mehr Agenten. Zum Abschluss kündigte Jia die TPU-Agent-Suite an, die sich jetzt in der Vorschau auf GitHub befindet und sich in Coding-Harnesses einklinken lässt, um Onboarding, Diagnose und Performance-Tuning zu automatisieren.
Zhou sagte, Metas PyTorch-Team habe TorchTPU gemeinsam mit Google entwickelt, "um die TPU zu einem erstklassigen nativen PyTorch-Ziel zu machen", und verwies auf Produktionsanforderungen hinsichtlich Performance, Zuverlässigkeit und Wartbarkeit. "All das ist Open Source und ab heute verfügbar, und es ist erst ein Anfang", sagte Zhou. Jana van Greunen, Director of PyTorch Engineering bei Meta, brachte die Motivation in der Ankündigung von Google Cloud auf den Punkt:
Bei Meta erfordert der Fortschritt an der KI-Front eine gewaltige Rechenkapazität und tiefe Hardware-Vielfalt. Wir dürfen uns nicht von einer einzigen Hardware-Architektur einschränken lassen.
Google war nicht allein. AWS hat TorchNeuron, ein natives PyTorch-Backend für seine Trainium-Chips, am 20. Oktober in die öffentliche Beta überführt, mit.to('neuron') als einziger Codeänderung. Beide Backends registrieren sich über PrivateUse1, PyTorchs Erweiterungspunkt für benutzerdefinierte Hardware. Die erste Version von TorchNeuron weist Lücken auf: The Next Web berichtete, dass dynamische Eingabe-Shapes noch nicht unterstützt werden und etwa 22.000 PyTorch-Tests übersprungen werden. In einer Analyse für Forkast argumentierte Blair Hayes, dass das Lock-in sich eher verschoben als aufgelöst habe:
Der PyTorch-Erweiterungspunkt bietet Entwicklern zwar eine gemeinsame Sprache, doch die Optimierungs- und Supply-Schichten bleiben fest in der Hand der Hersteller.
Auf Hacker News, wo der Thread zum TorchTPU-Start 379 Punkte erreichte, mischten sich Erleichterung und praktische Zweifel. "Ich erinnere mich an die Zeiten, in denen man gegen XLA kämpfen musste, um PyTorch auf TPUs zum Laufen zu bringen, es scheint, dass wir endlich First-Party-Support haben!", schrieb ein Kommentator. Andere fragten, wo man überhaupt eine TPU kaufen könne. Ein Kommentator, dessen Firma Googles On-Premises-TPUs geprüft hatte, reagierte nüchterner: "Wir haben sie evaluiert, uns aber entschieden, bei Nvidia zu bleiben, zumindest für eine weitere Generation."
Portabilität war auch unterhalb des Rechenzentrums das Verkaufsargument. In einer Session zum Deployment von Robot Policies mit ExecuTorch argumentierten Metas Anthony Shoumikhin und Jacob Szwejbka, dass Policies vom Training bis zum Gerät in PyTorch bleiben können, ohne Konvertierungsstack. Dieselben Quantisierungs- und Operator-Graphen laufen auf Targets von TensorRT auf NVIDIA Jetson bis OpenVINO auf Intel.
Die Trainingssessions bezifferten auch die Kostenseite. Bei der Präsentation des Reinforcement-Learning-Frameworks Miles sagte Yueming Yuan von RadixArk, dass die Verschmelzung zweier Log-Probability-Berechnungen in einem Kernel diesen Schritt mehr als zehnfach beschleunigt hat. Delta-Updates reduzierten in einem großen Lauf die pro Gewichtssynchronisation bewegte Datenmenge von 62 GB auf unter 1 GB.
Open-Source-Werkzeuge für das Training von Agenten mit RL zogen sich durch mehrere Sessions. Anyscales SkyRL trennt Training, Inferenz und Umgebungen und orchestriert sie mit Ray. Hugging Faces OpenEnv, das am 22. Oktober der Agentic AI Foundation beigetreten ist, verleiht jeder RL-Umgebung dieselbe Schnittstelle. Mit TRL und OpenEnv trainierte Hugging Faces Sergio Paniego Blanco ein kleines Liquid-AI-Modell durch vier Coding-Agente und steigerte dessen Punktzahl bei zurückgehaltenen Aufgaben von 42 auf 54 Prozent.
Für Teams, die einen Wechsel erwägen, gilt: Die Ein-Zeilen-Geräteänderung bringt ein Modell zum Laufen, aber nicht zum optimalen Lauf, daher sollte man Budget für Sharding- und Kernel-Arbeiten einplanen und zuerst die TPU-Kapazität bestätigen. Entwickler, die mehr erfahren möchten, können die TorchTPU-Ankündigung, das TorchTPU-Repository oder InfoQs Berichterstattung über die PyTorch Conference 2024 lesen. Die Aufzeichnungen der Sessions sollen innerhalb von zwei Wochen nach der Veranstaltung auf dem YouTube-Kanal der PyTorch Foundation erscheinen.
Präsentiert von: Martin Reynolds, Field CTO bei Harness, und Barani Mohandoss, Director, Cloud Governance, FinOps & E-Tools bei Trimble
Automatisch übersetzt. Das Original auf Englisch ist unten aufklappbar.
Original (Englisch) anzeigen
TorchTPU replaces PyTorch/XLA, a lazy-tensor bridge from 2020 that, according to the announcement, "required intrusive source-code modifications." The new backend aims to make porting a model as simple as changing model.to("cuda") to model.to("tpu"). "With TorchTPU, TPUs join GPUs and CPUs as a native option for PyTorch," Google Cloud wrote in its announcement, co-authored by Bill Jia, VP of engineering for Core ML/AI.
Jia presented the keynote "Workload Fungibility in the Agentic Era: Bringing Native PyTorch to Cloud TPUs" with Zhou, after two talks that framed the demand. Mark Collier, executive director of the PyTorch Foundation, said inference has overtaken training as the largest data center workload, creating "an incredible hunger for tokens." Collier described the community's goal as open source software for models that "run on any chip in any cloud and connect to any agent." The Foundation's keynote slides showed how fast that market moves: DeepSeek's Flash model became 60% cheaper in 37 days, and Kimi K3 ran 68% faster on the same hardware in 33 days.
Mazin Gilbert, executive director of the Agentic AI Foundation, said agent token consumption passed human consumption on February 6, 2026. It has since grown 14-fold, against 2.8-fold for humans. "So this is basically a hockey stick that's exploding," said Gilbert. Practitioners should check the scope before reusing those numbers, because the public data comes from a single platform, OpenRouter.
Because TorchTPU plugs into PyTorch's low-level dispatcher, the speakers said, Hugging Face models worked with it out of the box. The vLLM and SGLang inference engines run natively, and TorchTitan supports dense, mixture-of-experts, and diffusion models for training at scale. Ray and llm-d scale TPU workloads across hosts on Kubernetes. Four repositories were open sourced: TorchTPU, vLLM-TorchTPU, SGLang-TorchTPU, and TorchTitan.
Jia showed near-linear scaling past 8,000 TPU chips, with per-chip throughput holding roughly constant as the cluster grew. Google's published results include a Qwen3 235B mixture-of-experts run on 8,192 TPU v7x chips at 28% model FLOPs utilization. The announcement is candid that the one-line change is only a starting point:
One cannot achieve peak TPU performance with that simple change, since a model's shapes, sharding and ops may be skewed toward a GPU architecture; however, the model should run out of the box.
Google's answer to that tuning gap is more agents. Jia closed by announcing the TPU agent suite, now in preview on GitHub, which plugs into coding harnesses to automate onboarding, diagnostics, and performance tuning.
Zhou said Meta's PyTorch team co-developed TorchTPU with Google "to make TPU a first-class native PyTorch target," citing production needs for performance, reliability, and maintainability. "All of this is open source and available today and it is just a beginning," Zhou said. Jana van Greunen, director of PyTorch engineering at Meta, gave the motivation in Google Cloud's announcement:
At Meta, advancing the frontier of AI requires immense compute scale and deep hardware diversity. We cannot be constrained by a single hardware architecture.
Google was not alone. AWS put TorchNeuron, a native PyTorch backend for its Trainium chips, into public beta on October 20, with.to('neuron') as the only code change. Both backends register through PrivateUse1, PyTorch's extension point for custom hardware. TorchNeuron's first release has gaps: The Next Web reported that it does not yet support dynamic input shapes and skips about 22,000 PyTorch tests. In an analysis for Forkast, Blair Hayes argued that the lock-in has moved rather than disappeared:
While the PyTorch extension point provides a common language for developers, the optimization and supply layers remain firmly under vendor control.
On Hacker News, where the TorchTPU launch thread reached 379 points, relief mixed with practical doubts. "I remember the days when you had to fight XLA to make PyTorch run on TPUs, it seems we finally got first-party support!" wrote one commenter. Others asked where they could buy a TPU at all. A commenter whose company had looked at Google's on-premises TPUs was cooler: "We've evaluated them but decided to stick with Nvidia, at least for one more generation."
Portability was also the pitch below the data center. In a session on deploying robot policies with ExecuTorch, Meta's Anthony Shoumikhin and Jacob Szwejbka argued that policies can stay in PyTorch from training to the device, with no conversion stack. The same quantization and operator graphs run on targets from TensorRT on NVIDIA Jetson to OpenVINO on Intel.
The training breakouts put numbers on the cost side. Presenting the Miles reinforcement learning framework, Yueming Yuan of RadixArk said fusing two log-probability computations into one kernel made that step more than 10 times faster. Delta updates cut the data moved per weight sync from 62 GB to under 1 GB in one large run.
Open tooling for training agents with RL ran through several sessions. Anyscale's SkyRL separates training, inference, and environments and orchestrates them with Ray. Hugging Face's OpenEnv, which joined the Agentic AI Foundation on October 22, gives every RL environment the same interface. Using TRL and OpenEnv, Hugging Face's Sergio Paniego Blanco trained a small Liquid AI model through four coding agents, raising its score on held-out tasks from 42% to 54%.
For teams weighing a move, the one-line device change gets a model running, not tuned, so budget for sharding and kernel work and confirm TPU capacity first. Developers interested in learning more can read the TorchTPU announcement, the TorchTPU repository, or InfoQ's coverage of PyTorch Conference 2024. Session recordings are expected on the PyTorch Foundation's YouTube channel within two weeks of the event.
Presented by: Martin Reynolds - Field CTO at Harness, and Barani Mohandoss - Director, Cloud Governance, FinOps & E-Tools at Trimble